前言
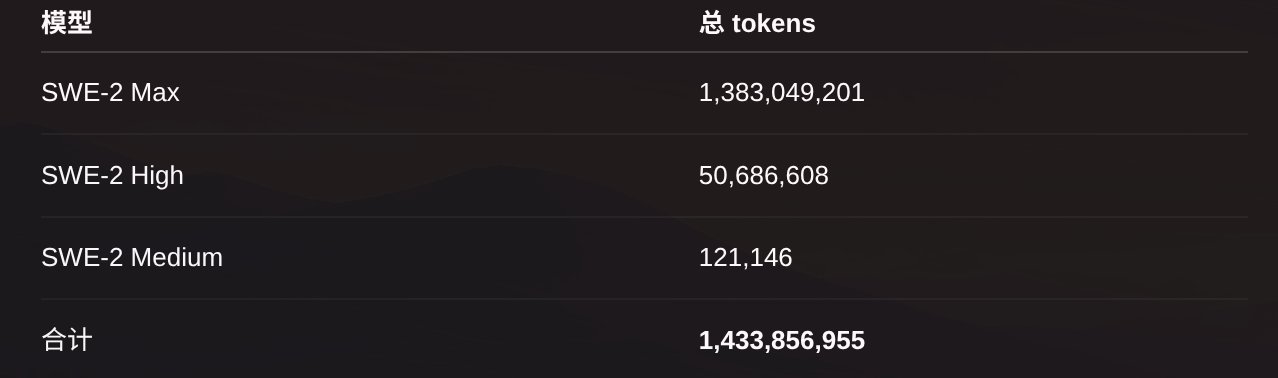
我用了1.4B的SWE 2.0,cognition真的很慷慨,让我20美元就能无限用一个基于Kimi K3的模型,只看性价比它简直就是无敌的. 但是使用体验来说,和它直接对话真的很困难.我认为它只适合作为供其他模型编排的廉价子代理使用(Devin的Fusion也是这么用的,让更强的模型作为总控向SWE子代理发消息).
它有什么问题?
指令遵循问题:我克隆了pi的代码库,在AGENTS.md中让它根据代码库"逐个函数"重新实现它,对于模型来说这明显是一个反直觉的指令,这意味着它每一轮都只需要写一个函数,然后就可以结束回合了 结果就是,对于这个反直觉的指令,Devin明显难以遵从,它每四轮就有一轮一口气生成整个文件,并意识不到自己做错了
意图理解问题:vibe coding的时候我们很难一轮初始prompt就表述清楚所有的细节,非要说的话,实现细节是抠不完的.我们只能尽力描述清晰,并使用提示词让它反复询问.但是SWE2.0在那些我们没有强调的边界总是糊弄了事,它只在乎自己做到了自己被要求的那部分(所以我们需要更能约束边界的主代理控制它)
这意味着什么?
这两个问题让SWE能且只能作为一个子代理行事:
- 在使用更强的模型编排,用SWE2.0作为子代理实现的情况下,强模型如Astra能更好的理清用户意图,写出更完整的目标和约束,在这个框架下运行的SWE子代理能够放心写代码.这也是Fusion能取得高分的原因之一,这是其"能"
- 我们自己则很难在这方面和模型相比,要表述同样明确的边界和目标,我们大概要花费数十倍于模型的时间,最终表述的清晰度还与模型本身提问的质量有关.甚至我们可能还会写出一些模糊的需要模型自己澄清的内容,这种情况下很难期待SWE2.0做出好的结果,这是其“只能”